
دوربین روشن میشود، برای مدت کوتاهی در ضبط کننده ظاهر میشود، سپس دوباره ناپدید میشود. چند دقیقه بعد این توالی تکرار میشود. تعویض کابل رابط چیزی را تغییر نمیدهد. قبل از اینکه دوربین را خراب کنید، بررسی کنید که آیا سوئیچ عمداً برق آن را قطع میکند یا خیر.
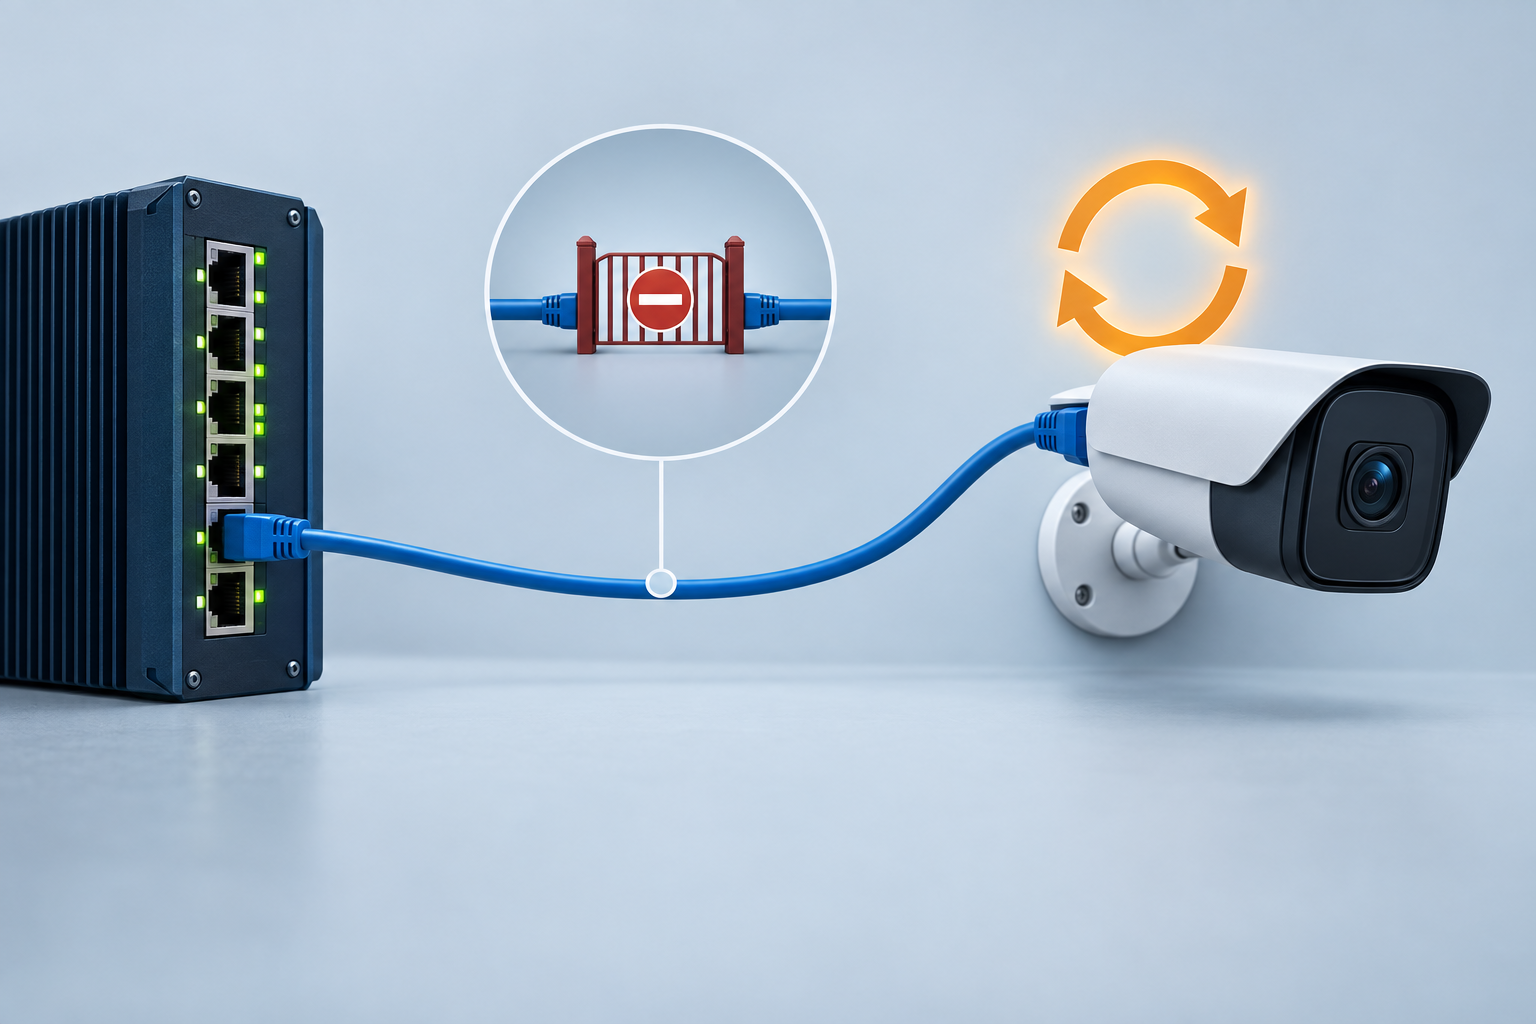
یک ناظر PoE معمولاً یک وضعیت پیکربندی شده را زیر نظر دارد و در صورت عدم موفقیت آن وضعیت، یک اقدام بازیابی را آغاز میکند. بسته به محصول، این ممکن است شامل یک کاوشگر دسترسی و یک چرخه برق باشد. اگر وضعیت به اشتباه پیکربندی شده باشد، مسدود شده باشد یا قبل از اتمام راهاندازی ارزیابی شده باشد، عملکرد بازیابی میتواند باعث قطع مکرر شود.
وظیفه فوری این است که مشخص شود چه کسی شروع به راهاندازی مجدد کرده است. وظیفه بلندمدتتر این است که قانون بازیابی را با یک خرابی واقعی سرویس مطابقت دهیم. یک آدرس IP قابل دسترسی، یک جریان ویدیویی سالم و یک دستگاه با قدرت پایدار به هم مرتبط هستند، اما آنها یک مشاهده یکسان نیستند.
قبل از تغییر تایمر، توالی رویداد را حفظ کنید
رویدادهای PoE موجود در سوئیچ، زمان روشن بودن دستگاه، رویدادهای ضبط کننده و پیکربندی watchdog را جمعآوری کنید. تأیید کنید که ساعتهای آنها به اندازه کافی برای مقایسه توالی هماهنگ هستند. ناپدید شدن دوربین در ابتدا و شروع مجدد watchdog بعداً نشان میدهد که زنجیره رویدادهای متفاوتی از قطع برق سوئیچ در حالی که دوربین در حال کار بوده است، وجود دارد.
به دنبال یک بازه تکرار شونده باشید. اگر ریتم قطع برق با بازه زمانی پروب پیکربندی شده، آستانه پروب ناموفق و رفتار راهاندازی مجدد مطابقت داشته باشد، آن یک سرنخ مفید است. این سرنخ تا زمانی که گزارشها یا یک آزمایش کنترلشده، قطع برق را به اقدام نگهبان متصل کند، باقی میماند.
در صورت امکان عملیاتی، بازیابی خودکار را برای پورت آزمایشی آسیبدیده موقتاً غیرفعال کنید و در عین حال برق PoE معمولی را حفظ کنید. بررسی کنید که آیا دوربین روشن میماند یا خیر. تغییر را از طریق فرآیند تعمیر و نگهداری تأیید شده اعمال کنید، آن را مستندسازی کنید و پس از تشخیص، تنظیمات بررسی شده را بازیابی کنید. یک دستگاه پایدار در طول این آزمایش، منطق تریگر را نشان میدهد؛ این ثابت نمیکند که شبکه گستردهتر سالم است.
تنظیمات را به صورت یک دنباله بخوانید، نه به صورت اعداد جداگانه
پیادهسازی محصولات متفاوت است. برای مثال،دفترچه راهنمای سوئیچ مدیریتی موکسابررسی خرابی دستگاه PoE را با IP هدف، دوره بررسی، تعداد پاسخهای ناموفق و اقدام مربوطه مستند میکند. این مثال انواع تنظیمات مورد نیاز برای بررسی را توضیح میدهد؛ اما تنظیمات یا قابلیتهای مدل TODAHIKA را مشخص نمیکند.
برای سوئیچ واقعی، توالی را از روشن شدن تا نظارت عادی ترسیم کنید. هرگونه تأخیر در شروع به کار، مکانیسم کاوش، تعداد خرابیهای مورد نیاز، مدت زمان خاموش شدن و دوره انتظار برای راهاندازی مجدد را شناسایی کنید. بپرسید که پس از بازیابیهای ناموفق مکرر چه اتفاقی میافتد. برخی از پیادهسازیها کنترل بیشتری نسبت به سایرین ارائه میدهند.
| تنظیم یا رفتار | سوال برای پاسخ | شکستی که میتواند ایجاد کند |
|---|---|---|
| آدرس هدف | آیا این آدرس فعلی و مورد نظر نقطه پایانی است؟ | یک دستگاه سالم به دلیل نظارت بر یک آدرس قدیمی، مجدداً راهاندازی میشود. |
| منبع و مسیر کاوش | آیا کاوشگر خود سوئیچ میتواند به هدف برسد؟ | پینگ موفق یک تکنسین، مشکل VLAN یا مسیریابی سمت سوئیچ را پنهان میکند. |
| کمک هزینه راه اندازی | شمارش خرابیها چه زمانی پس از وصل شدن برق شروع میشود؟ | دوربین قبل از اتمام بوت شدن، ریست میشود |
| آستانه شکست | چه مدت زمانی از رویداد باید باعث ایجاد اقدام شود؟ | یک وقفه کوتاه در شبکه باعث بازیابی غیرضروری میشود |
| سیاست تلاش مجدد | آیا بهبودی پس از شکستهای مکرر متوقف میشود یا تشدید میشود؟ | سیستم به طور نامحدود در حلقه تکرار قرار میگیرد و شواهد مفید را از بین میبرد. |
پراب را از جای صحیح آزمایش کنید
پینگ کردن موفقیتآمیز دوربین توسط لپتاپ، ثابت نمیکند که واچداگ میتواند به آن دسترسی پیدا کند. لپتاپ ممکن است در VLAN دوربین باشد در حالی که رابط مدیریت سوئیچ در جای دیگری باشد. یک قانون دسترسی ممکن است به لپتاپ اجازه دسترسی بدهد اما سوئیچ را مسدود کند. همچنین ممکن است هدف به بررسی خاصی که سوئیچ استفاده میکند، پاسخ متفاوتی بدهد.
رابط منبع واقعی و رفتار کاوشگر پشتیبانی شده را در مستندات سوئیچ بررسی کنید. آدرس هدف، زیرشبکه، عضویت VLAN، مسیریابی و قوانین دسترسی مربوطه را تأیید کنید. اگر دوربین از طریق DHCP آدرس جدیدی دریافت کرده باشد، یک هدف نگهبان ثابت اکنون ممکن است به دستگاه دیگری یا اصلاً هیچ چیز دیگری اشاره نکند.
این مشکل را با غیرفعال کردن گستردهی بخشبندی یا باز کردن دسترسیهای غیرضروری حل نکنید. ارتباط خاص مورد نیاز توسط عملکرد بازیابی تأیید شده را برقرار کنید. اگر عملکرد نمیتواند در سراسر طراحی مدیریت مورد نظر عمل کند، به جای تضعیف کل شبکهی اطراف آن، یک ترتیب نظارتی پشتیبانیشده انتخاب کنید.
ضبط بسته میتواند زمانی که رابط جزئیات کافی را نشان نمیدهد، مفید باشد. از یک نقطه مشاهده تایید شده استفاده کنید و بررسی کنید که آیا پروبها خارج میشوند، آیا پاسخها برمیگردند و آیا مسیر برگشت به سوئیچ میرسد یا خیر. فقط ترافیک مورد نیاز برای تشخیص را ضبط کنید و مهرهای زمانی را که میتوان با رویدادهای برق مقایسه کرد، نگه دارید.
روی یک مثال زمانبندی راهاندازی کار کنید
فرض کنید یک دوربین پس از وصل مجدد برق، ۱۱۰ ثانیه طول میکشد تا در پیکربندی عملیاتی پذیرفتهشده خود پاسخگو شود. تصور کنید یک دوربین نظارتی پس از ۳۰ ثانیه شروع به شمارش خرابیها میکند، هر ۱۰ ثانیه بررسی میکند و پس از سه خرابی عمل میکند. اگر اولین بررسیهای شمارششده در ثانیههای ۳۰، ۴۰ و ۵۰ رخ دهند، دوربین نظارتی میتواند مدتها قبل از رسیدن دوربین به نقطه آمادگی ۱۱۰ ثانیهای مشاهدهشده، آن را مجدداً راهاندازی کند.
این ارقام نشاندهندهی یک تداخل زمانی هستند؛ این تنظیمات توصیه نمیشوند. زمانبندی واقعی اولین پروب و معنای آستانه به سوئیچ بستگی دارد. رفتار راهاندازی دوربین را با لوازم جانبی، میانافزار و سرویسهای شبکهی مورد نیاز اندازهگیری کنید، سپس میزان مجاز پشتیبانیشده را بر اساس آن پیکربندی کنید.
بیش از یک راهاندازی مجدد سریع و گرم را آزمایش کنید. شروع سرد، بررسی ذخیرهسازی یا راهاندازی مجدد همزمان سرویسهای بالادستی میتواند زمان بیشتری ببرد. پاکت راهاندازی پذیرفتهشده را در پرونده نگه دارید. اگر تغییر میانافزار بهطور قابلتوجهی آن پاکت را تغییر میدهد، به جای اینکه تایمر قدیمی را بهعنوان یک تایمر دائمی صحیح در نظر بگیرید، رفتار watchdog را در آزمایش بهروزرسانی لحاظ کنید.
تشخیص خطای دوربین از خطای مسیر
چندین خرابی مختلف میتواند منجر به از دست رفتن پاسخ شود. ممکن است دوربین هنگ کرده باشد، کابل آن قطع شده باشد، یک VLAN تغییر کرده باشد یا یک مسیر بالادستی از کار افتاده باشد. راهاندازی مجدد دوربین فقط میتواند به برخی از این موارد کمک کند.
یک مقایسه مفید، دامنه رویداد است. اگر هر دوربین پشت یک uplink تقریباً همزمان از کار بیفتد، یک مسیر مشترک یا مشکل برق شایسته توجه است. اگر یک دوربین به طور مکرر زمان روشن بودن خود را از دست میدهد در حالی که دستگاههای همسایه پایدار میمانند، آن نقطه پایانی و پورت آن را بررسی کنید. این الگوها آزمایش بعدی را هدایت میکنند. آنها به خودی خود قطعی نیستند.
از فعال کردن قوانین بازیابی تهاجمی یکسان در یک گروه بزرگ دوربین بدون یک پایلوت خودداری کنید. یک وقفه در شبکه مشترک میتواند باعث شود بسیاری از سوئیچها که در غیر این صورت نقاط پایانی کار میکنند، با هم چرخه برق را از دست بدهند. ترافیک راهاندازی بعدی و از دست دادن پوشش ضبط شده میتواند اختلال اولیه را طولانیتر کند.
پاسخ پینگ، سرویس ویدیو را تأیید نمیکند
مشکل متضاد، دوربینی است که به watchdog پاسخ میدهد در حالی که جریان آن غیرقابل استفاده است. دسترسی اولیه میتواند در حالی که یک جلسه ضبط، فرآیند رمزگذار یا مسیر برنامه با شکست مواجه شده است، سالم باقی بماند. افزایش تعداد بررسیهای پینگ، آن بررسی را به یک آزمایش سلامت ویدیو تبدیل نمیکند.
مشخص کنید که سایت چه چیزی را باید تشخیص دهد. اگر نیاز مربوط به تداوم ضبط است، از ضبط کننده یا یک مانیتور برنامه مناسب برای مشاهده آن سرویس استفاده کنید. عملکرد بازیابی سوئیچ ممکن است همچنان مفید باشد، اما نقش آن باید به طور دقیق بیان شود. یک ناظر دسترسی اولیه را به عنوان مدرکی برای بازیابی ویدیوی سرتاسری تبلیغ نکنید.
هنگام ارزیابی یکسوئیچ PoE صنعتیبپرسید که دقیقاً کدام مدلها و نسخههای میانافزار از بازیابی خودکار پشتیبانی میکنند، چه چیزی را رصد میکنند و کدام تنظیمات در دسترس هستند. یک عبارت در سطح خانواده مانند «PoE watchdog» برای طراحی سیاست خطا کافی نیست.
یک نقطه توقف به بازیابی خودکار اضافه کنید
یک سیستم بازیابی بدون مراقبت باید در صورت عدم امکان بازیابی سرویس، شواهدی از خود به جا بگذارد. در صورت پشتیبانی، از یک محدودیت تلاش مجدد مناسب، افزایش تأخیر یا تشدید هشدار استفاده کنید. اگر سوئیچ فاقد این کنترلها است، به جای فرض اینکه چرخه مصرف برق بیپایان قابل قبول است، آن محدودیت را در طراحی نظارت گستردهتر برطرف کنید.
دلیل هر اقدام، پورت آسیبدیده و زمان قطع و وصل برق را در صورت امکان ثبت کنید. بازیابی ناموفق مکرر، اطلاعات مفیدی برای نگهداری است. این اطلاعات میتواند یک خطای کابلکشی مداوم، یک هدف غیرقابل دسترس یا دستگاهی که نیاز به توجه دارد را شناسایی کند.
از الزامات عملیاتی محلی برای انتخاب تعادل بین سرعت بازیابی و تنظیم مجددهای غیرضروری استفاده کنید. یک دوربین از راه دور بدون تکنسین در نزدیکی، ممکن است پاسخ متفاوتی از یک نقطه پایانی در یک مرکز با پرسنل دائمی را توجیه کند. سیاست انتخاب شده باید از نظر در دسترس بودن خدمات و شواهد قابل توضیح باشد، نه صرفاً تمایل به استفاده از کوتاهترین زمانبندی مجاز در منو.
بررسی قانون با خطاهایی که علل متفاوتی دارند
برای پذیرش، حداقل موارد پشتیبانیشدهی مربوطه را بررسی کنید: دستگاهی که کند شروع به کار میکند، یک خرابی واقعی در نقطهی پایانی، یک وقفهی موقت در مسیر و یک هدف نادرست یا غیرقابل دسترس. این موارد را در یک محیط نگهداری ایزوله یا تأیید شده انجام دهید. ثبت کنید که آیا رویداد مورد انتظار شناسایی شده است، آیا برق وصل شده است و آیا سرویس مفید بازگشته است یا خیر.
همچنین وضعیت سالم بودن دستگاه را برای یک دوره مشاهده کافی بررسی کنید. یک قانون بازیابی که به درستی به یک خطای اجباری واکنش نشان میدهد اما تجهیزات سالم را در طول ترافیک عادی مجدداً راهاندازی میکند، برای استقرار آماده نیست. تداوم و زمان روشن بودن نقطه پایانی ضبطکننده را با سابقه رویداد سوئیچ مقایسه کنید.
تحویل نهایی باید شامل آدرس هدف، مسیر کاوش، منطق زمانبندی، محدودیتهای بازیابی و مقصد تشدید باشد. هنگامی که قطع مکرر بعدی رخ میدهد، این رکورد به اپراتور اجازه میدهد تا تلاش برای تعمیر را از خود خطا تشخیص دهد و بخش صحیح سیستم را تغییر دهد.
زمان ارسال: ۱۸ سپتامبر ۲۰۲۶


